 2014, Vol. 31

电子信息技术的迅猛发展使得语音识别技术也取得了可喜的成绩,在苹果、HTC等智能手机上已经出现了初步的语音识别功能,但是要达到成熟的技术还有一段漫长而艰难的路程.现阶段的语音识别技术在识别率、识别时间、降低噪音以及系统资源耗费方面还存在很多不足.因此,针对大词汇量下语音识别时间过长、资源占用较大,本文提出语音分组识别算法.为了保证分组后识别率不下降,还要对组特征进行置信度检验,确保分组稳定性.
1 算法选择语音识别技术中最常用的方法主要有:动态时间规整(DTW),隐马尔科夫模型(HMM),人工神经网络(ANN)[1].由于HMM拥有较高的识别率,所以受到广大研究者的青睐.完整的语音识别算法主要包括预处理,特征提取以及模式匹配3个部分.
1.1 预处理对输入的原始语音信号进行端点检测,包括预滤波、采样与量化、加窗、分帧、端点检测和预加重等,滤除其中不必要的信息及噪声[2-3].有效的端点检测不仅能使处理时间减到最小,而且能排除无声段的噪声干扰,从而使识别系统具有良好的识别性能.预加重的目的是平滑信号以消除声道模型中的极点带来的影响,便于进行频谱分析或声道采样参数分析.一般通过传递函数为Hz=1-az-1的滤波器对其滤波.设n时刻的语音采样值为x(n),经过预加重处理后为
y(n)=x(n)-αx(n-1), 0.9 < α < 1.0,
其中,α为预加重系数.加窗分帧是为提取特征参数做准备.
1.2 特征提取为了去除语音识别中的冗余信息,获得说话人的基本特征的有用信息,需要对语音信号进行分析处理,这一过程就是特征提取.因此,要求特征提取后的信息必须能够有效地区分不同的说话人,且对同一说话人的变化保持相对稳定.目前主要采用的语音特征参数为线性预测倒谱系数(LPCC)和Mel频率倒谱参数(MFCC).由于MFCC能够比较充分利用人耳的听觉特性,同时研究表明MFCC参数能够比LPCC参数更好地提高系统的识别性能[4-5],因此本文选用MFCC参数作为语音特征.
1.3 模式匹配隐式马尔可夫模型(HMM)[6-7]是20世纪80年代引入语音识别的理论,是马尔科夫链的一种.声学中各个相对稳定的发音单位(可以是一个完整的音节、声母、韵母或更精细的音素)对应于HMM中的隐含状态.状态是未知的,但是可以通过观察序列(一帧帧的MFCC参数)得到.匹配方法上采用概率密度函数计算语音参数对HMM模型的输出概率,通过搜索最佳状态序列,以最大后验概率为准则找到识别结果.
语音识别中,一个HMM模型应包含4个状态,每个状态包含3个正态高斯概率密度函数(PDF),每个PDF都有各自的均值矢量和协方差矩阵.这些均由MFCC参数计算得到.
总之,HMM的精髓在于:观察可测,状态隐含.
2 语音分组算法HMM模型在匹配时,需要对每个语音模板进行逐一比对,计算与每一个模板的输出概率,以输出概率最高者为最终识别结果.但是,当模板较多时,对模板一一匹配所用时间较长,对内存占用较大,需要的处理器性能也较高,不满足用户及时性和低消耗的实际需要.为了克服以上困难,需要对语音模板进行分组.识别时,首先判断语音在哪一个组,然后对所在组的语音模板进行逐一匹配,以输出概率最高的模板为识别结果.语音分组算法具体如下:
(1) 将语音特征参数MFCC先按状态数分段,再按每个状态的高斯概率密度函数的个数分段,每一段作为最小的处理单元.
(2) 将每一段K均值聚类[8]且聚为1类.
(3) 把每个状态的聚类结果合并.
(4) 把同一语音的所有模板的合并结果再合并,继续K均值聚类且聚为1类.
(5) 将不同语音的聚类结果合并,最后K均值聚类,根据实际需要,分成多少组就聚成多少类.聚类的结果将成为最后的组特征.
(6) 将每一组进行置信度检验,设定置信度达到90%视为分组稳定,如果达不到要求将重新分组,直到分组稳定.
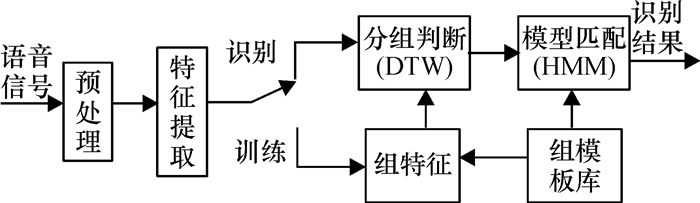
分组语音的识别流程如图 1所示.
|
图 1 语音分组识别框图 Figure 1 Diagram speech recognition by group |
由图 1可知,先要对语音分组进行判断,确定要识别的语音在哪一个组,采用动态时间弯折算法(DTW)[9-10].其核心是通过欧氏距离公式计算与每个组的距离,距离最近的组表明是识别语音所在的组.欧氏距离公式为
| $d = \sqrt {\sum\limits_{i = 1}^n {{{\left( {{x_{i1}} - {x_{i2}}} \right)}^2}} }, $ |
其中,xi1表示第1个点的第i维坐标, xi2表示第2个点的第i维坐标.
确定语音所在的组后,需要采用HMM算法对组内的模板进行逐一匹配,其核心是通过计算输出概率确定识别结果,以输出概率最高的模板为语音识别结果.概率输出公式为
| $\mathit{P = }{\left( {2{\rm{ \mathsf{ π} }}\Pi \left( \mathit{\boldsymbol{v}} \right)} \right)^{ - 0.5}} \cdot {{\rm{e}}^{\left( { - 0.5 * \left( {\mathit{\boldsymbol{x - m}}} \right)/\mathit{v} * \left( {\mathit{\boldsymbol{x - m}}} \right)\mathit{'}} \right)}} $ |
其中,v是方差向量,∏(v)表示v内所有元素相乘,x是输入向量,m是均值向量[11].
3 置信度检验在进行K均值聚类时,由于初值的选定具有一定的随机性,分组的结果可能因为初值选取的不同而不同,导致分组不稳定.而稳定的分组对能否正确识别语音至关重要,因此需要通过置信度检验确保分组稳定性,从而保证语音识别率足够高.
分组后的聚类结果即组特征,其矩阵中每一行为一个组的均值(记作μ0).需要从每一个组内随机抽取一些样本,当样本足够多(其数量记作n),可以认为其近似服从正态分布.计算出样本的均值X和方差S,由统计学可知,检验统计量
| $\left| t \right| \ge {t_{\frac{\beta }{2}}}\left( {n - 1} \right) $ | (1) |
β为显著性水平,1-β为置信度.当代入数字计算后,如果|t|满足式(1),说明t在拒绝域中,拒绝H0接受H1,即分组不稳定;如果|t|不满足式(1),说明t没有在拒绝域,接受H0拒绝H1,即分组稳定.
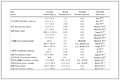
4 实验结果与分析对生活中的常用词语发音进行测试,其中100个人,每个人100个词,每个词录音10遍.前80个人的录音作为训练数据,后20个人的录音作为测试数据.训练时分别进行分组数设定3、5、10,分组置信度检验阈值设定为90%.特征参数选用MFCC,分帧时帧长256个点,帧移80个点,数字滤波器选取24个[12-14].与没有分组的HMM算法进行识别率和识别时间对比,结果如表 1所示.
|
表 1 不同分组数下的识别结果 Table 1 The recognition results under different numbers of groups |
由表 1可知,当未进行分组(分组数为1),其识别时间较长,但识别率最高.随着分组数的增加,识别时间明显减少,能够满足实际需要,但识别率略有下降.
与传统分组的HMM算法进行比较,结果如表 2所示.
|
|
表 2 置信度分组与传统分组的比较 Table 2 Comparison between confidence groups and traditional groups |
由于传统分组只是对语音进行简单的K均值聚类,从而把语音分成多个组,并不能确保分组稳定.由表 2可知,进行置信度检验的分组算法比传统分组的识别率高,且随着分组数量的增加,识别率高的优势增大,而识别时间与传统分组一样.原因是在分组训练时增加了置信度检验,确保了分组稳定性,使得识别率与传统分组识别率有所增加.又由于置信度检验是在训练数据时完成的,并不占用识别阶段的时间,所以识别时间与传统分组识别时间相同.
5 分组策略的选择语音识别中,识别率与识别时间往往是冲突的,如表 1所示.权衡这二者关系时,如何进行分组至关重要,特别是在语音识别应用上尤为突出.
本文以识别率降低的百分比和识别时间减少的百分比作为参考,前者越小越好,后者越大越好.最优分组就是时间减少百分比减去识别率降低百分比的最大值所在的分组.其数学公式为
| $ {T_{\max }} = \frac{{{B_{n - 1}} - {B_n}}}{{{B_{n - 1}}}} \times 100\% - \frac{{{A_{n - 1}} - {A_n}}}{{{A_{n - 1}}}} \times 100\%, n = 2, 3, \cdots . $ |
n表示第n种分组情况,每一种分组情况有各自的识别率An和识别时间Bn,
本文将分组识别算法与置信度检验相结合[15],应用于语音识别.通过对非特定人、孤立词、较大词汇量语音识别实验表明,这种方法能够减少识别时间,同时由于匹配模板的减少也能够节约系统资源,降低对硬件性能的要求,从而节约成本,满足用户及时性和低成本的需求.不足之处是识别率略有下降,如何在分组情况下保证识别率不下降甚至提高还需要进一步研究.
| [1] |
周志华, 陈世福. 神经网络集成[J].
计算机学报, 2002, 25(1): 1-8.
Zhou Z H, Chen S F. Neural network ensemble[J]. Chinese Journal of Computers, 2002, 25(1): 1-8. |
| [2] |
李锦, 何培宇. 一种改进的基于小波去噪HMM非特定人语音识别算法[J].
四川大学学报:自然科学版, 2007, 44(1): 69-72.
Li J, He P Y. An improved algorithm of speech recognition based on wavelet denoising HMM speaker-independent[J]. Journal of Sichuan University: Natural Science Edition, 2007, 44(1): 69-72. |
| [3] |
杨毅, 杨宇, 余达太. 语音增强及其消噪能力研究[J].
微电子学与计算机, 2006, 23(7): 203-208.
Yang Y, Yang Y, Yu D T. Speech enhancement and the study of eliminate noise[J]. Microelectronics & Computer, 2006, 23(7): 203-208. |
| [4] |
张震, 王化清. 语音信号特征提取中Mel倒谱系MFCC的改进算法[J].
计算机工程与应用, 2008, 44(22): 54-58.
Zhang Z, Wang H Q. The improved algorithm of MFCC in speech signal feature extraction[J]. Computer Engineering and Applications, 2008, 44(22): 54-58. DOI: 10.3778/j.issn.1002-8331.2008.22.015. |
| [5] |
魏星, 周萍. 语音识别系统及其特征参数的提取研究[J].
计算机与现代化, 2009(9): 228-243.
Wei X, Zhou P. Speech recognition system and the study of its characteristic parameters extraction[J]. Computer and Modernization, 2009(9): 228-243. |
| [6] |
王坤卿. HMM模型在语音识别研究中的应用[J].
电脑知识与技术, 2008, 14(7): 1966-1968.
Wang K Q. HMM model in the application of speech recognition study[J]. Computer Knowledge and Technology, 2008, 14(7): 1966-1968. |
| [7] |
张杰, 黄志同, 王晓兰. 语音识别中隐马尔可夫模型状态数的选取原则及研究[J].
计算机工程与应用, 2000, 36(1): 67-69, 133.
Zhang J, Huang Z T, Wang X L. The selection principle and study on the number of state of HMM in speech recognition[J]. Computer Engineering and Applications, 2000, 36(1): 67-69, 133. |
| [8] |
李凯, 常圣领. 基于k-means聚类的神经网络分类器集成方法研究[J].
计算机工程与应用, 2009, 45(22): 120-123.
Li K, Chang S L. The integration method study based on the k-means clustering neural network classifier[J]. Computer Engineering and Applications, 2009, 45(22): 120-123. DOI: 10.3778/j.issn.1002-8331.2009.22.039. |
| [9] |
王倩, 吴国平, 陈琳. 特定人语音识别算法一DTW算法[J].
软件导刊, 2005(20): 48-50.
Wang Q, Wu G P, Chen L. Speaker-dependent speech recognition algorithm-DTW algorithm[J]. Software Guide, 2005(20): 48-50. |
| [10] |
李邵梅, 刘力雄, 陈鸿昶. 实时说话人辨识系统中改进的DTW算法[J].
计算机工程, 2008, 34(4): 218-219.
Li S M, Liu L X, Chen H C. The improvement of DTW algorithm on the real-time speaker recognition system[J]. Computer Engineering, 2008, 34(4): 218-219. |
| [11] |
何强, 何英.
MATLAB扩展编程[M]. 北京: 清华大学出版社, 2002.
|
| [12] |
Franco H, Neumeyer L, Digalakis V, et al. Combination of machine scores for automatic grading of pronunciation quality[J].
Speech Communication, 2000, 30(2-3): 121-130.
DOI: 10.1016/S0167-6393(99)00045-X. |
| [13] |
Fukuda N. Orthogonalized distinctive phonetic feature extraction for noise robust automatic speech recognition[J].
IEICE Transactions on Information and Systems, 2004: 1110-1118.
|
| [14] |
Li X, Jiang H, Liu C. Large margin HMM for speech recognition[C]//Proceedings of ICASSP05, 2005: 513-516.
|
| [15] |
梁家恩. 语音识别中的置信度研究与应用[D]. 北京: 中国科学院自动化研究所, 2006.
|