 2026, Vol. 56


海洋水色观测研究的数据来源主要包括现场观测与卫星遥感两大体系[1]。其中依赖船测与浮标的现场观测站点分布稀疏且维护成本高昂,难以满足大范围、长期连续监测的需求,因此大尺度海域的观测主要依赖于卫星遥感反演技术[2]。然而,卫星观测受重访周期与云层遮蔽等因素制约。传统极轨卫星由于轨道设计的限制,对同一区域的观测存在时间间隔,导致其日尺度数据产品在空间覆盖上存在严重缺口[3-4]。为克服重访周期这一瓶颈,静止轨道卫星成为理想选择[5]。该类卫星固定于地球某点上空,能够对覆盖区域进行高频次、不间断的观测,从根本上避免了极轨卫星的轨道间隙问题[6],大幅减少了数据缺失,将剩余缺失的主因缩减为云层遮蔽[7-8]。但静止卫星轨道高度更高,受观测距离与传感器限制,其空间分辨率往往低于极轨卫星[9]。
针对数据缺失与分辨率不足这两类问题,机器学习,尤其是深度学习方法,近年来展现出强大潜力。在数据缺失重建方面,掩码学习框架(如MAE(Masked autoencoder)、DINCAE(Data-interpolating convolutional auto-encoder))通过在训练过程中以掩码遮蔽方式主动遮蔽图像,构建“破损-完整”样本对,使模型学习从部分观测中恢复全局信息的能力[10-11]。在空间分辨率提升(超分辨率)方面,深度学习模型通过学习低分辨率与高分辨率图像间的复杂非线性映射,可显著提升图像的空间细节[12-13]。
然而,现有研究通常将“缺失重建”与“超分辨率”视为两个独立的步骤或任务分别处理。这种割裂的范式存在明显局限:超分辨率模型通常假设输入是完整的,当面对真实卫星数据中大面积、不规则的云遮蔽时,其常规的训练方式会出现对云层缺失位置数据的错误处理;而缺失重建方法则多聚焦于恢复原分辨率图像,并未考虑提升空间细节。因此,开发一种能够同步处理云遮蔽并提升空间分辨率的一体化框架,对于生成真正可用、高质量、高覆盖的海洋遥感数据产品至关重要。
海表叶绿素a浓度是量化浮游植物生物量、评估海洋初级生产力及监测水体富营养化的关键生态参数[14-15]。日本葵花(Himawari)系列静止气象卫星自2015年起,持续发布包括叶绿素a在内的多光谱遥感产品,具备对覆盖区域(西太平洋等)提供高时空精度观测数据的潜力[16]。但受数据开放政策等因素影响,其公开发布的高空间分辨率(0.01°)海洋水色产品,空间覆盖范围被限定于日本周边海域(24°N—50°N, 123°E—150°E);与之相对,覆盖整个观测圆盘(60°S—60°N, 80°E—160°W)的数据产品则仅提供较低的空间分辨率(0.05°)[17],导致研究者在使用葵花系列数据研究其他海域时,缺乏更高精度的空间细节观测数据。
针对上述问题,本研究提出并实现了一种融合动态云遮蔽训练机制的遥感图像超分辨率重建一体化框架:该方法以葵花8号卫星的叶绿素a产品为例,直接以存在云遮蔽的、覆盖全域的低分辨率(0.05°)圆盘数据作为输入,通过在超分辨率重建任务的训练过程中对训练图像施加模拟云层的遮蔽,使得模型获得从被云体遮蔽的部分有效观测中推理完整空间结构的能力,同步完成“空间分辨率提升(至0.01°)”与“数据缺失重建”两个核心任务,最终生成一套覆盖西太平洋全域、时空连续、无云遮蔽的高分辨率叶绿素a数据产品。
1 数据与方法 1.1 数据获取与预处理本研究使用的核心遥感数据源自日本葵花8号静止气象卫星发布的海洋水色产品。针对西太平洋海域,该卫星提供了两种不同空间分辨率的数据集:第一套是覆盖整个卫星观测圆盘(60°S—60°N, 80°E—160°W)的全域数据,其空间分辨率为0.05°(经纬度),每日提供一幅观测图像;第二套日尺度产品仅覆盖日本周边区域(24°N—50°N, 123°E—150°E),其空间分辨率为0.01°(经纬度)。两套数据时间跨度均为2015年7月2日至2022年12月13日。
原始高分辨率卫星数据中存在较多噪声,尤其在云遮蔽区域边缘表现明显。在开展模型训练前,需对原始数据进行清洗与对齐。为提高监督标签的质量,我们选择对高分辨率数据采用3×3窗口的双边滤波处理。该方法通过结合空间邻近度和像素值相似度进行加权平均,虽然会带来细微的分辨率损失,但能有效去除云遮蔽区域边缘的不可靠像素。随后,我们对低分辨率数据及滤波后的高分辨率数据进行了系统化标记:将原始值中小于等于0及无效值NaN的像素统一标记为-2,用以表征云层遮挡或反演异常导致的无效缺失;同时,基于来自Natural Earth数据库的陆地轮廓数据集[18]生成海陆掩膜,将所有陆地区域标记为-1。最终,我们获得了时空严格对齐的两套数据集:覆盖日本周边区域(24°N—50°N, 123°E—150°E)的低分辨率(0.05°)数据及其对应的高分辨率(0.01°)滤波数据。
在数据组织阶段,采用以中心时刻t为基准、前后各包含T帧的时间窗口构建方式,形成“低分辨率多帧输入-高分辨率中心帧输出”的样本结构。本研究设置T=7,即每个样本包含前后共15 d(2T+1=15帧)的低分辨率序列作为输入,以中心时刻对应的高分辨率帧作为监督目标。该选择基于7 d涵盖天气尺度(Syno-ptic scale)变化,已有研究表明该尺度足以捕捉叶绿素a对动力过程的短期响应[19],在模型容量与信息量之间取得平衡。在训练阶段,使用该重叠区域内的数据构建训练样本对,时间上选取2015年7月2日至2020年12月31日作为模型训练集,2021年1月1日至2021年12月31日作为验证集,2022年1月1日至2022年12月13日作为测试集。训练得到模型后,可将整个卫星观测圆盘(60°S—60°N, 80°E—160°W)的低分辨率(0.05°)全域数据以相同的多帧时间窗口组织方式输入训练好的模型,实现对西太平洋海域的高分辨率重建。受时间窗口结构影响,完整数据集首尾各7 d无法作为中心时刻构建样本,因此模型实际重建输出的时间范围为2015年7月9日至2022年12月6日。
此外,为客观评估模型重建结果的精度与可靠性,本研究引入了全球Argo浮标计划发布的生物地球化学剖面数据(Argo-BGC)中的表层叶绿素a浓度测量值[20-21],以该测量值作为现场验证数据。从Argo全球海洋观测网中筛选出2015年7月2日至2022年12月13日期间,覆盖研究区域的所有剖面数据。在变量选取方面,本研究严格提取了经过质量控制(QC=1)的校正叶绿素a浓度(CPHL_ADJUSTED)及相应的校正深度(PRES_ADJUSTED),并设定0~10 m深度范围作为表层代表值。针对数据噪声与物理合理性,剔除了非正值的异常记录,并通过日尺度平均聚合处理,最终获得了5 326条独立有效的Argo海洋表层数据。
1.2 模型与方法本研究提出了融合动态云遮蔽训练的遥感图像超分辨率重建一体化框架,旨在同步实现“空间分辨率提升”与“数据缺失重建”两个任务。该框架以西太平洋全域的低分辨率(0.05°)葵花8号叶绿素a日尺度产品作为输入,输出同一区域的高分辨率(0.01°)且无云遮蔽的叶绿素a数据。为实现这一目标,本研究选择了轻量高效的ESPCN(Efficient sub-pixel convolutional neural network)[22]作为核心架构,并融合了动态云遮蔽训练策略。整个技术流程主要包括数据预处理、动态云遮蔽训练策略、超分辨率模型的构建与训练、全域推理与评估检验等核心阶段(见图 1)。

|
( 图中展示了从低分辨率输入到高分辨率输出的完整流程,突出展示了动态云掩膜策略与ESPCN训练过程的整合。This diagram illustrates the complete workflow from low-resolution input to high-resolution output, highlighting the integration of the dynamic cloud masking strategy with the ESPCN training process. ) 图 1 融合动态云遮蔽的ESPCN超分辨率重建技术路线图 Fig. 1 Technical roadmap of the ESPCN super-resolution reconstruction integrating dynamic cloud masking |
为使模型能够有效处理含有云遮蔽状态的缺失遥感数据,在训练过程中对输入图像施加模拟云层的遮蔽。该策略的核心思想源于我们先前关于叶绿素a数据重建的研究[23],该研究提出了一种融合真实云形态、散点随机掩码与连续块状掩码的动态复合掩码方法,用于模拟卫星数据中复杂多样的缺失场景,并成功实现了黄渤海区域叶绿素a数据的无缺失重建。具体实现如下:在每一轮训练迭代中,随机抽取一种掩码,将其施加在输入的低分辨率多帧数据的目标中心帧上,将遮蔽位置的数值设置为-2。考虑到现实云层往往处于离散与连续并存的状态,我们以等概率随机选取以下三种掩码形态:(1)真实云形态掩码。从训练样本中随机抽取其他时刻的真实云遮蔽分布图(即值为-2的像素位置),将其覆盖至当前输入帧,模拟真实的云层遮蔽现象。(2)散点随机掩码。以一定比例随机遮蔽图像中的像素点,模拟极端的离散遮蔽。(3)连续块状掩码。生成随机位置与大小的矩形遮蔽区域,模拟极端的连续遮蔽。此外,遮蔽的总体面积比例根据研究区域历史缺失率的统计分布进行动态抽样。具体的遮蔽形式如图 2所示。通过这种动态掩蔽机制,使模型学习如何从被不同云层形态部分遮蔽的观测中推理出完整的空间细节与纹理信息。

|
( 在训练过程中对目标图像进行三种遮蔽的形态示意图,第一行为散点遮蔽,第二行为块状遮蔽,第三行为真实云形态遮蔽。During the training process, three types of masking are applied to the target images. The first row shows scatter masking, the second row shows block masking, and the third row shows real cloud pattern masking. ) 图 2 三种遮蔽方式示意图 Fig. 2 Schematic diagram of three masking methods |
ESPCN是一种轻量级全卷积网络架构,其核心在于亚像素卷积层(Sub-pixel convolution),该层通过在通道维度重组特征,直接将低分辨率特征图高效地重组为高分辨率输出,避免了传统上采样方法(如反卷积或插值)可能引入的伪影和计算冗余。该选择基于模型性能、计算效率与任务适配性的综合权衡。首先,ESPCN结构轻量,在有限计算资源下允许使用更大的批次规模进行训练,这有助于梯度估计的稳定性,且其相对较小的参数规模也构成了一种隐式正则化,使得模型在面对带有噪声的标签训练时,更倾向于学习数据中低分辨率到高分辨率映射的稳健核心规律,而非过度拟合标签中的局部噪声与异常波动[23],从而提升了模型在实际应用中的泛化能力。其次,ESPCN作为一种全卷积网络架构,具备处理可变尺寸输入的能力,结合其小参数量与高效前向计算的特性,使其能够直接对覆盖西太平洋全域的低分辨率圆盘数据进行一次性完整推理,避免了因现存或模型架构限制的区块化分割处理而引入的拼接伪影与边界不一致问题,保证了输出场的空间连续性与一致性。
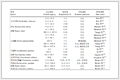
模型的超分辨率任务为在纬度和经度方向均实现5倍的上采样(0.05°→0.01°)。针对本任务中经纬度方向均为5倍上采样的特点,我们对标准ESPCN进行了适应性改动,设计了可处理矩形上采样的亚像素卷积适配层,确保输出网格严格符合空间对应关系。网络结构主要包括输入层、帧融合层、两个卷积层(含ReLU激活)、输出卷积层及自适应的亚像素重组层。该网络的结构细节如表 1所示,其轻量高效的特点为后续的长时间序列全域推理奠定了基础。
|
表 1 ESPCN模型结构配置 Table 1 Configuration of ESPCN model structure |
模型训练在配备NVIDIA GPU的工作站上进行,使用Tensorflow/python的深度学习框架,Adam优化器。
由于输入数据及对应标签在1.1节数据预处理中已将无效值标记为特定值(-1表示陆地,-2表示云遮蔽)的像素,为引导模型仅学习有效位置的标签信息,本次任务中的损失函数及所有评价指标均通过乘以有效位置掩码矩阵Mi, j的方式进行计算,该矩阵定义为当标签值位于有效范围(大于0)时Mi, j=1,否则为0。针对叶绿素a浓度值呈现明显长尾分布的特性,损失函数选用对数平均绝对误差(log-MAE),其完整定义如下:
| $ \mathrm{Loss}_{\log -\mathrm{MAE}}=\frac{\sum\limits_{i, j}\left(\boldsymbol{M}_{i, j} \cdot\left|\log _{10} y_{i j}-\log _{10} \widehat{y}_{i j}\right|\right)}{\sum\limits_{i, j} \boldsymbol{M}_{i, j}} 。$ | (1) |
式中:yij为高分辨率标签值
训练过程中采用了多项策略以提升模型性能与训练效率。动态云遮蔽增强策略在每个训练批次中随机选择一种掩码类型对输入帧进行遮蔽(具体行为见1.2节动态云遮蔽设置)。空间数据增强方面,以0.5的概率对输入样本施加水平、垂直或同时翻转,避免模型过度依赖海陆边界等固定空间模式。优化策略上,使用检查点机制监控验证集损失,并据此动态调整训练进程。若验证损失连续10个周期未下降,学习率降至原来的一半;若验证损失连续20个周期未下降,则触发早停机制,同时保存验证损失最佳的网络权重。模型训练批次大小设为32,最大训练周期上限为1 000个周期。
2.2 模型训练结果模型训练过程损失结果如图 3所示。在训练初期(Epoch 1—25),训练损失与验证损失均呈现快速下降趋势,训练损失由初始的约0.62迅速降至约0.11,验证损失由约0.24同步下降至约0.11。验证集初始损失较低可能因其样本中有效观测比例更高。随后,模型收敛速度放缓,各项指标逐渐趋于平稳。至第49周期时,首次触发学习率下降机制(由0.001调整至0.000 5),此后模型进入稳定优化阶段,损失值在极小范围内波动下降。在第151周期时,模型达到最低验证损失0.100;随后连续20个周期(Epoch 151—171)验证损失未再下降,因而触发预设的早停机制,训练自动终止。

|
( 训练损失与验证损失随训练周期的变化曲线,箭头标注处为最佳验证损失节点。图中Epoch为训练周期;Loss为训练损失;Val_Loss为验证损失;LR为学习率。The variation curves of training loss and validation loss with the training period. The arrow indicates the nodes with the best validation loss. Epoch denotes the training epoch; Loss is the training loss; Val_Loss is the validation loss; and LR is the learning rate. ) 图 3 模型训练阶段损失曲线 Fig. 3 Training loss curves of the model |
最终,我们选取了第151周期保存的模型权重作为最佳模型,在训练集、验证集及测试集上进行推理,并计算了相关量化指标,结果汇总于图 4。从量化指标来看,模型在各数据集上均表现出一致的重建精度,测试集上的峰值信噪比(PSNR)超过50 dB,皮尔逊相关系数(r)高于0.86,均方根误差(RMSE)与平均绝对误差(MAE)也维持在较低水平,这证实了模型预测值与标签值之间存在稳定的强线性相关。从具体数值来看,测试集上的PSNR为50.02 dB,MAE为0.107,RMSE为0.433,与训练集(MAE为0.113,RMSE为0.502)、验证集(MAE为0.140,RMSE为0.526)的表现基本持平,且测试集的指标略优,而三者的r值差异极小(分别为0.863、0.869、0.861),这证明模型在训练过程中未出现过拟合现象,具有良好的泛化能力。测试集指标略优于验证集,可能与测试集时段内云覆盖率或海洋动力条件相对平稳有关。需说明的是,除实际数据集特征差异外,这种微小波动可能源于评估过程中动态云遮蔽的随机性,同理,此评估结果与训练过程中151周期的评估损失也存在微小差异,但其各评估过程的结果波动较小,这进一步证明了模型的泛化能力。对图 4中密度散点分布图进行观察与分析,可以更深入地评估模型在不同数值区间的重建能力。该分布图呈现出以下显著特征:首先,数据样本主要集中在[0, 40]mg/m3这一数值区间内。在高值区域,散点分布呈现出向x轴下偏的趋势,表明模型对高值样本存在一定程度的低估。这一现象符合机器学习的统计学回归特性,即在预测离群值时,模型倾向于向统计均值靠拢,从而产生常见的统计偏差。其次,坐标轴附近出现了较为显著的平行延伸结构,这意味着模型在某部分采样点上的推断数值与标签数值存在较大偏差,但这并非直接意味着模型在这部分数据上预测不佳。考虑到本研究采用的高分辨率卫星标签本身含有一部分难以剥离的噪声,这种分布特征反映出模型并未盲目拟合所有观测特征,而是展现出了一定的自适应特征选择能力。最后,三个数据集的分布形态具有高度的一致性,这进一步验证了模型推断逻辑的可靠性与泛化性能。

|
( (a)训练集预测值与标签值的密度散点图;(b)验证集密度散点图;(c)测试集密度散点图。色条表示各区间数据点的频数,采用对数刻度。图中指标含义:Loss为对数平均绝对误差(log-MAE);MAE为平均绝对误差;RMSE为均方根误差;r为皮尔逊相关系数;PSNR为峰值信噪比。(a) Density scatter plot of predicted vs. labeled values on the training set; (b) Density scatter plot on the validation set; (c) Density scatter plot on the test set. The color bar shows the frequency of points in each bin on a logarithmic scale. Metrics in the panels: Loss denotes the logarithmic mean absolute error (log-MAE); MAE is the mean absolute error; RMSE is the root mean square error; r is the Pearson correlation coefficient; PSNR is the peak signal-to-noise ratio. ) 图 4 各数据集的模型预测散点密度分布 Fig. 4 Scatter density distribution of model predictions on different datasets |
为验证模型的泛化能力与重建效果,本文使用训练完成的最佳模型,在关闭动态云遮蔽增强的条件下,对训练区域(日本周边海域)的数据进行完整推理,如图 5所示,模型得到了训练区域的完整重建形态,其对于缺失数据的填补表现出物理合理的填补和良好的边界连续性,没有出现不良伪影或噪声,这进一步佐证了模型的稳健性。

|
( (a)—(d)分别为2021年1月1日、4月1日、7月1日、10月1日的高分辨率标签图像;(e)—(h)为对应日期的模型超分辨率重建结果。(a)—(d): High-resolution label images on Jan. 1, Apr. 1, Jul. 1, and Oct. 1, 2021, respectively; (e)—(h): Corresponding super-resolution reconstruction results from the model. ) 图 5 训练区域超分辨率重建结果对比 Fig. 5 Comparison of super-resolution reconstruction results in the training area |
综合上述各项指标对比,模型达到了预期的训练效果,能够稳健地实现重建任务。
3 模型应用 3.1 全域数据集生成与检验ESPCN作为一种全卷积网络架构,具备处理可变尺寸输入的能力。模型在经过(24°N—50°N, 123°E—150°E)范围的数据进行训练后,便可直接接收覆盖西太平洋全域(60°S—60°N, 80°E—160°W)的低分辨率圆盘数据(2 401像素×2 401像素),进行一次性完整推理,模型的直接推理输出为对应范围内12 001像素×12 001像素的完整预测场,在此基础上,需进行后处理将陆地区域及圆盘四角的无效观测区域标记为-1等特定无效值。经试验,模型在葵花8的全观测域内实现了有效的重建,其全域重建结果如图 6所示,模型成功得到了不同于训练区域的全域完整重建形态,同时表现出良好的物理逻辑性填补和边界连续性。

|
( (a)—(d)分别为2021年1月1日、4月1日、7月1日、10月1日的输入低分辨率圆盘数据;(e)—(h)为对应日期模型输出的高分辨率全域重建结果。(a)—(d): Input low-resolution full-disk data on Jan. 1, Apr. 1, Jul. 1, and Oct.1, 2021, respectively; (e)—(h): Corresponding high-resolution full-disk reconstruction results from the model. ) 图 6 葵花8卫星全域重建结果 Fig. 6 Full-disk reconstruction results of Himawari-8 satellite |
为客观评估重建数据的可靠性,本研究引入经预处理后(详见1.1节)的独立Argo浮标剖面数据作为真值进行验证。在卫星与浮标的匹配策略上,本研究采用了严格的时空配准方案。时间上要求卫星观测与浮标采样日期精确一致,空间上则设置了0.1°的搜索半径,提取该范围内距离浮标位置最近的有效像元值。匹配结果如图 7显示,原始低分辨率卫星数据成功匹配样本3 783个,而重建后的高分辨率数据集成功匹配样本提升至5 141个,匹配量的增加直观反映了模型对原始数据空缺区域的有效修复能力。

|
( (a)原始低分辨率卫星产品与Argo浮标实测数据的对比散点图;(b)本文重建的高分辨率数据集与Argo浮标实测数据的对比散点图;(c)重建数据集在原始产品缺失区域与Argo浮标实测数据的对比散点图。图中N为匹配样本量;RMSE为均方根误差;MAE为平均绝对误差;虚线为1∶1参考线(y=x)。(a) Scatter plot comparing original low-resolution satellite product with Argo float in-situ data; (b) Scatter plot comparing our reconstructed high-resolution dataset with Argo float in-situ data; (c) Scatter plot comparing reconstructed dataset with Argo float in-situ data in regions where original products were missing. N denotes the number of matched samples; RMSE is the root mean square error; MAE is the mean absolute error; the dashed line is the 1∶1 reference (y=x). ) 图 7 基于Argo浮标的散点图验证 Fig. 7 Scatter plot validation with Argo float |
从统计评估结果来看,原始低分辨率数据与Argo浮标对比的均方根误差(RMSE)为0.693,平均绝对误差(MAE)为0.203;而重建后的高分辨率数据在样本量大幅增加的情况下,RMSE显著下降至0.289,MAE降低至0.171。同时,通过提取在重建数据集中额外出现的新匹配点,在1 379个数据点中,评估结果显示RMSE为0.315,MAE为0.187,与整体重建数据集的评估结果相近。上述结果表明,相较于原始观测,重建数据集与现场观测的一致性更高,且在原始数据空缺区域仍保持了良好的准确性与稳定性,这验证了模型在填补数据空缺方面的有效性。
图 8进一步展示了三种数据集与Argo浮标实测数据的逐月误差时间序列验证。从整体变化趋势来看,三种数据验证结果均表现出较为明显的季节性波动。其中,重建后的高分辨率数据集及其在原始产品缺失区域的新增匹配点均呈现出冬季误差偏高、夏季误差偏低的现象,但逐月RMSE与MAE均控制在1.2以下,整体误差水平较低。

|
( 图中给出三组数据与Argo浮标匹配数据间的逐月平均绝对误差(MAE)和均方根误差(RMSE)。第一组为原始低分辨率卫星产品;第二组为本文重建的高分辨率数据集;第三组为原始产品缺失、但重建结果仍可与Argo匹配的新增站点。实线表示MAE,虚线表示RMSE。The figure shows monthly mean absolute error (MAE) and root mean square error (RMSE) for three Argo-matched datasets. The first is the original low-resolution satellite product; the second is the reconstructed high-resolution dataset; the third includes only the additional matchups that appear after reconstruction in regions where the original product was missing. Solid lines denote MAE; dashed lines denote RMSE. ) 图 8 基于Argo浮标的逐月误差时间序列验证 Fig. 8 Monthly error time series validation with Argo float |
对比误差指标可知,图 7与图 8中RMSE普遍高于MAE,表明数据集中普遍存在少量大偏差的离散点,使得对离散偏差更为敏感的RMSE数值相对更高。值得注意的是,原始低分辨率数据的RMSE峰值存在明显的离群现象,其峰谷变化与其他两种数据差异较大,尤其在2022年春夏季出现了显著的极高值峰,最高RMSE达到约3.5,反映出原始数据存在较大的离散偏差;相比之下,重建数据集的逐月误差波动更平稳,表明模型在重建过程中可有效抑制输入异常点的影响,实现生成更稳定可靠的重建结果。
3.2 数据集应用本研究生成的超分辨率无缺失数据集为大范围海域的连续高精度观测提供了关键的数据支撑。重建图像有效克服了原始低分辨率观测中像元大面积缺失与细节分辨率不足的问题,特别是在环境演变剧烈的近岸海域,如河流入海口等高度动态变化的区域,其应用价值尤为突出。图 9对比了2021年7月1日我国四大入海口(珠江、长江、黄河、辽河)的观测结果,图 9(a)—9(d)展示的原始低分辨率数据因受云层遮挡缺失及空间分辨率不足的限制,无法有效地刻画地物的空间形态;而图 9(e)—9(h)显示的重建结果则精确勾勒出了叶绿素a浓度的精细分布。

|
( (a)—(d)分别为珠江入海口、长江入海口、黄河入海口、辽河入海口原始低分辨率数据;(e)—(h)为对应区域的重建高分辨率结果。(a)—(d) Original low-resolution data for the Pearl River Estuary, Yangtze River Estuar, Yellow River Estuar, and Liao River Estuar, respectively; (e)—(h) Correspon-ding reconstructed high-resolution results. ) 图 9 重建数据集入海口数据分析 Fig. 9 Analysis of reconstructed dataset in estuary areas |
值得注意的是,重建图像清晰地捕捉到了入海口显著的羽状锋(Plume front)特征,即高浓度径流与低浓度外海水交汇形成的清晰边界,这一现象在珠江口重建图 9(e)中尤为典型,细长的羽状结构自口门向外海延伸,展现了精细的扩散形态细节[24-25];其次,叶绿素a浓度在部分径流区内出现较为显著的低值区,即沿河流下游至外海方向,呈现出“低-高-低”的抛物线式变化趋势,这与近岸水体中光照、营养盐及稀释作用的经典认知相符[26-27]。重建结果对这一空间模式的直观呈现,表明该数据集能够有效还原关键的生物地球化学过程信号。
4 结语本研究针对静止轨道卫星海洋水色数据存在的空间分辨率不足与云层遮挡问题,成功构建并验证了一种融合动态云遮蔽训练的超分辨率重建方法。该方法以ESPCN模型为核心,通过嵌入模拟真实缺失场景的动态复合掩码训练策略,使模型能够在完成5倍空间分辨率提升(0.05°→0.01°)的同时,同步实现数据缺失区域的有效重建。试验证明,该方法在训练区域各数据集中表现稳健,重建精度高。
基于此框架模型,本研究生产了一套覆盖西太平洋全域(60°S—60°N, 80°E—160°W)、时间跨度为2015—2022年的高分辨率(0.01°)、时空连续、无云遮蔽的叶绿素a浓度数据集。通过与国际Argo浮标实测数据的严格对比验证,重建数据集在样本匹配数量和数值精度(RMSE和MAE)上均显著优于原始低分辨率产品,这证实了其可靠性和准确性。案例分析进一步表明,该数据集能够精细刻画珠江口等典型区域的羽状锋及叶绿素浓度梯度变化,为近岸海域环境动态监测、陆海相互作用研究及海洋生态评估提供了高质量的关键数据。本研究提出的方法框架可以克服光学遥感中云遮挡和分辨率瓶颈,为生成高可用性的地球系统科学数据产品提供了一条有效的技术路径。
| [1] |
Martin S. An Introduction to Ocean Remote Sensing[M]. 2nd ed. Cambridge: Cambridge University Press, 2014.
(  0) |
| [2] |
International Ocean-Colour Coordinating Group. Why Ocean Colour? The Societal Benefits of Ocean-Colour Technology[R]. Dartmouth: International Ocean-Colour Coordinating Group, 2008.
( 0) |
| [3] |
Gregg W W, Woodward R H. Improvements in coverage frequency of ocean color: Combining data from SeaWiFS and MODIS[J]. IEEE Transactions on Geoscience and Remote Sensing, 1998, 36(4): 1350-1353. DOI:10.1109/36.701084 ( 0) |
| [4] |
McClain C R. A decade of satellite ocean color observations[J]. Annual Review of Marine Science, 2009, 1: 19-42. DOI:10.1146/annurev.marine.010908.163650 ( 0) |
| [5] |
Kurihara Y, Murakami H, Kachi M. Sea surface temperature from the new Japanese geostationary meteorological Himawari-8 satellite[J]. Geophysical Research Letters, 2016, 43(3): 1234-1240. DOI:10.1002/2015GL067159 ( 0) |
| [6] |
Murakami H. Ocean color estimation by Himawari-8/AHI[C]//Proceedings of SPIE 9878. Bellingham: SPIE, 2016: 987810.
( 0) |
| [7] |
Shen H, Li X, Cheng Q, et al. Missing information reconstruction of remote sensing data: A technical review[J]. IEEE Geoscience and Remote Sensing Magazine, 2015, 3(3): 61-85. DOI:10.1109/MGRS.2015.2441912 ( 0) |
| [8] |
Lattanzio A, Grant M, Doutriaux-Boucher M, et al. Assessment of the EUMETSAT multi decadal land surface albedo data record from meteosat observations[J]. Remote Sensing, 2021, 13(10): 1992. DOI:10.3390/rs13101992 ( 0) |
| [9] |
Wu P, Shen H, Zhang L, et al. Integrated fusion of multi-scale polar-orbiting and geostationary satellite observations for the mapping of high spatial and temporal resolution land surface temperature[J]. Remote Sensing of Environment, 2014, 156: 169-181. ( 0) |
| [10] |
He K, Chen X, Xie S, et al. Masked autoencoders are scalable vision learners[C]//Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition. New York: IEEE, 2022: 16000-16009.
( 0) |
| [11] |
Barth A, Alvera-Azcárate A, Ličer M, et al. DINCAE 1.0:A convolutional neural network for sea-surface temperature and chlorophyll data interpolation[J]. Geoscientific Model Development, 2020, 13(12): 6021-6039. ( 0) |
| [12] |
Dong C, Loy C C, He K, et al. Image super-resolution using deep convolutional networks[J]. IEEE Transactions on Pattern Analysis and Machine Intelligence, 2016, 38(2): 295-307. DOI:10.1109/TPAMI.2015.2439281 ( 0) |
| [13] |
Yang S, Ebrahimian H, Zhang Z, et al. Deep learning for single-image super-resolution in remote sensing: A review[J]. International Journal of Remote Sensing, 2026, 47(3): 1061-1103. DOI:10.1080/01431161.2025.2600100 ( 0) |
| [14] |
Falkowski P G, Raven J A. Aquatic Photosynthesis[M]. 2nd ed. Princeton: Princeton University Press, 2013.
( 0) |
| [15] |
Smith V H. Eutrophication of freshwater and coastal marine ecosystems a global problem[J]. Environmental Science and Pollution Research, 2003, 10: 126-139. DOI:10.1065/espr2002.12.142 ( 0) |
| [16] |
Japan Meteorological Agency. Himawari-8/9 Himawari Standard Data User's Guide[R]. Tokyo: Japan Meteorological Agency, 2017.
( 0) |
| [17] |
JAXA Earth Observation Research Center. JAXA Himawari Monitor: User Guide[EB/OL]. (2025-09-30)[2026-02-06]. https://www.eorc.jaxa.jp/ptree/userguide.html.
( 0) |
| [18] |
Natural Earth. Free vector and raster map data[EB/OL]. (2026-03-22)[2026-03-26]. https://www.naturalearthdata.com/.
( 0) |
| [19] |
Cen H, Han G, Lin X, et al. Deep learning-based forecasting model for chlorophyll-a response to tropical cyclones in the Western North Pacific[J]. Ocean Modelling, 2024, 189: 102345. DOI:10.1016/j.ocemod.2024.102345 ( 0) |
| [20] |
Argo. Argo float data and metadata from Global Data Assembly Centre (Argo GDAC)[EB/OL]. SEANOE, [2026-03-26]. https://doi.org/10.17882/42182.
( 0) |
| [21] |
Biogeochemical-Argo Planning Group. The Scientific Rationale, Design and Implementation Plan for a Biogeochemical-Argo Float Array[R]. Ifremer: Argo Data Management, 2016.
( 0) |
| [22] |
Shi W, Caballero J, Huszár F, et al. Real-time single image and video super-resolution using an efficient sub-pixel convolutional neural network[C]//Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition. New York: IEEE, 2016: 1874-1883.
( 0) |
| [23] |
Wang J, Wang W, Zhou G. Dynamic masking for chlorophyll-a reconstruction in the Bohai and Yellow Sea: Dataset generation and trend analysis[J]. Environmental Research Communications, 2026, 8(4): 045017. DOI:10.1088/2515-7620/ae5766 ( 0) |
| [24] |
Geman S, Bienenstock E, Doursat R. Neural networks and the bias/variance dilemma[J]. Neural Computation, 1992, 4(1): 1-58. DOI:10.1162/neco.1992.4.1.1 ( 0) |
| [25] |
Horner-Devine A R, Hetland R D, MacDonald D G. Mixing and transport in coastal river plumes[J]. Annual Review of Fluid Mechanics, 2015, 47: 569-594. DOI:10.1146/annurev-fluid-010313-141408 ( 0) |
| [26] |
Warrick J A, Farnsworth K L. Coastal river plumes: Collisions and coalescence[J]. Progress in Oceanography, 2017, 151: 245-260. DOI:10.1016/j.pocean.2016.11.008 ( 0) |
| [27] |
Cloern J E, Jassby A D. Drivers of change in estuarine-coastal ecosystems: Discoveries from four decades of study in San Francisco Bay[J]. Reviews of Geophysics, 2012, 50(4): RG4001. ( 0) |